建立不上網的私人大型AI模型,規劃工作站時要注意的事
本篇由MOUSER、Amphenol贊助製作
作者:Sam 徐豐智
每當我們遇到以下幾個狀況時,需要思考如何規劃工作站,讓AI可以順暢的跟每一個用戶溝通
AI任務的設計規模:
1、長期使用超過100B參數的免費AI模型(比如700B以上模型或分散運算式模型)
2、讓多人團隊共用一組AI模型
3、使用AI Agent,一個任務需要十幾次AI模型思考(Thought)、行動(Action)、觀察(Observation)
4、常需要AI模型一次處理數百頁的書籍或是幾個小時的會議紀錄逐字稿
5、需要在同一套系統中同時運行多個專用模型時
處理「超長上下文」的記憶體會遇到什麼考驗?
當我們要求 AI 一次處理數百頁的商業合約、厚重的書籍,或長達數小時的會議逐字稿時,會產生極為龐大的「超長上下文(Long Context)」。
在這類任務中,效能瓶頸往往不是模型本身的參數大小,而是隨著文章長度呈幾何級數暴增的「上下文快取(KV Cache)」。單一台工作站的記憶體(即使高達一百多GB)很容易因為快取被瞬間塞滿而導致系統崩潰(OOM)。透過叢集運算,我們可以將這些海量的暫存記憶池分散到多台機器上共同分擔,讓 AI 能真正「記住」所有細節並順暢給出精準的答案。
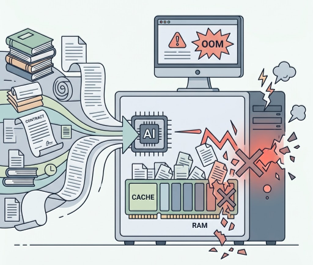
KV Cache過高導致系統崩潰(Gemini AI生成示意圖)
運行「Multi-Agent System」的多工協作有什麼需求?
在複雜的企業工作流程中,我們常需要使用 AI Agent 進行十幾次的思考、行動與觀察,甚至在同一個系統裡同時呼叫多個專用的 AI 模型(例如:讓視覺模型分析圖表、程式模型撰寫代碼、推理模型進行最終決策)。
要讓多個不同專業的大型模型「同時掛載」在記憶體中並隨時待命,單機的容量無法負荷。藉由叢集運算,能將多個模型分散部署在不同的運算節點上,並讓它們同步運作、即時交換資訊。這種跨節點的無縫協作,是實現 Multi-Agent 系統的基礎。
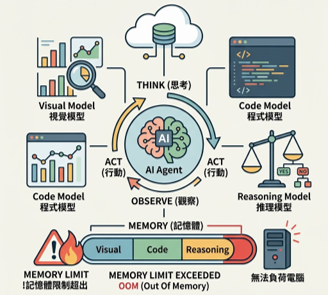
位同時處理任務,多種模型同時掛載於記憶體中(Gemini AI生成示意圖)
為什麼算力夠了,AI 模型處理任務還是很慢?(因為資料傳輸速度跟不上)
大模型時代的分散式運算
在使用幾百億甚至上千億參數的大型語言模型(LLM)與 AI Agent,資料量龐大到早已無法塞進單一工作站或單張 GPU 中。為了讓模型順暢運作,我們必須將龐大的計算任務拆分,交由多台機器組成的運算叢集共同處理。
訊息傳遞的「接力賽」瓶頸
這就像是一支由頂尖短跑選手組成的接力賽隊伍,即使每位選手(GPU 算力)跑得再快,如果交接棒(網路傳輸)過程頻繁卡頓或出錯,整隊的總成績依然會非常糟糕。在 AI 運算過程中,各台機器需要極為頻繁地交換權重資料與計算結果(例如 All-Reduce 過程)。
GPU 閒置與算力浪費
當網路頻寬不足或傳輸延遲過高時,強大的 GPU 就算每秒能算幾十億次,也只能被迫停下來「等待數據送達」。這種因為網路跟不上而發生的塞車現象,就是導致「明明硬體算力買夠了,AI 回應卻依然很慢」的最主要原因。
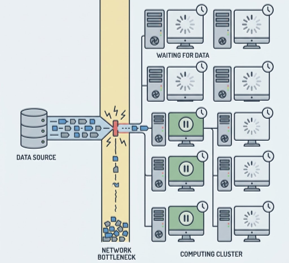
Gemini AI生成示意圖
以 NVIDIA DGX Spark 為例,背面的 ConnectX-7 網卡具備的高速網路能力。透過配備 Amphenol 等高品質 QSFP-DD 傳輸線,能確保兩台設備之間跑出接近 200 Gb/s 的實測頻寬。這種「八線道高鐵」等級的傳輸管道,能確保資料即時送達 GPU,讓模型推理與訓練暢行無阻。
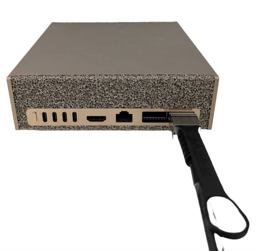
NVIDIA DGX Spark Plugging in a QSFP Cable
為什麼叢集運算連線機器超過三台時,需要注意交換器?
直連與環狀拓撲的局限(2 至 3 台)
當我們只串接 2 台工作站時,用一條纜線直接對接即可;到了 3 台時,還可以透過 3 條線串成實體的「環狀網路(Ring Topology)」來互相通訊。然而,這種依靠線材直連的方法,當機器數量繼續增加,就會遇到物理與效能瓶頸。
四台以上的「全方位通訊」挑戰
當機器擴展到 4 台(或以上)時,例如執行 4 節點的張量平行運算(Tensor Parallelism),運算過程中的每一層都需要 4 台機器同時且頻繁地「互相傳輸資料」(Any-to-Any 通訊)。如果此時還用線材互相直連,不僅網卡插槽數量不夠用,資料還必須經過中間機器多次轉手,造成嚴重的延遲。可以參考NVIDIA社群提供的設定教學。
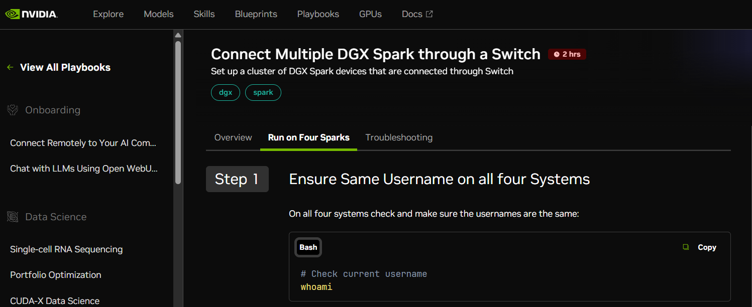
Connect Multiple DGX Spark through a Switch
使用高速交換器的目的
超過 3 台機器時必須導入具備 200G/400G QSFP-DD 連接埠的高速網路交換器。交換器能建立以它為中心的高效能「星型拓撲」,讓每一台 DGX Spark 都能以滿速(約 195.7~196 Gb/s)同時與其他任何節點溝通。確保傳輸不掉速,未來調整平行算力配置時,也只需透過軟體修改設定,不用重新拔插或更換線材。以下是Amphenol Commercial提出的通訊解決方案資訊,供大家評估測試。
改善數據傳輸速度的基礎硬體
什麼是 Amphenol QSFP-DD 互連系統(HSIO-CN)?
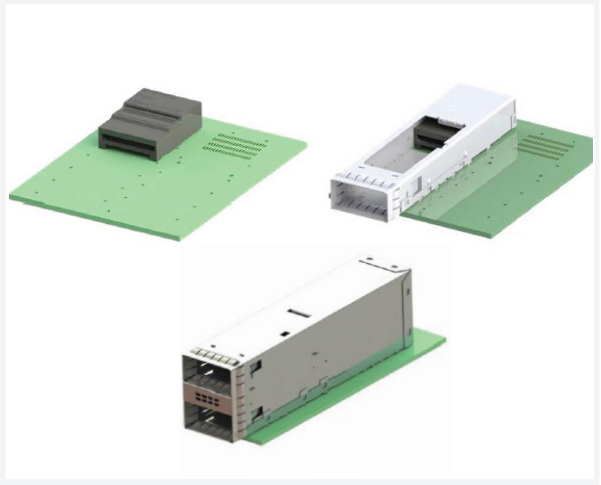
要打破數據傳輸塞車的瓶頸,關鍵就在於伺服器與主機板端的高速連接介面。Amphenol Commercial 推出的 QSFP-DD(Double Density,雙密度)互連系統,採用 76-position、0.8mm Pitch 的高密度連接器與外殼(Cage)設計。傳統 QSFP 通常具備 4 個資料通道,而 QSFP-DD 在相同的面板外觀尺寸下將通道數量提升至 8 個通道(8-lane),提高單一介面卡的數據傳輸密度。(完整資料連結)
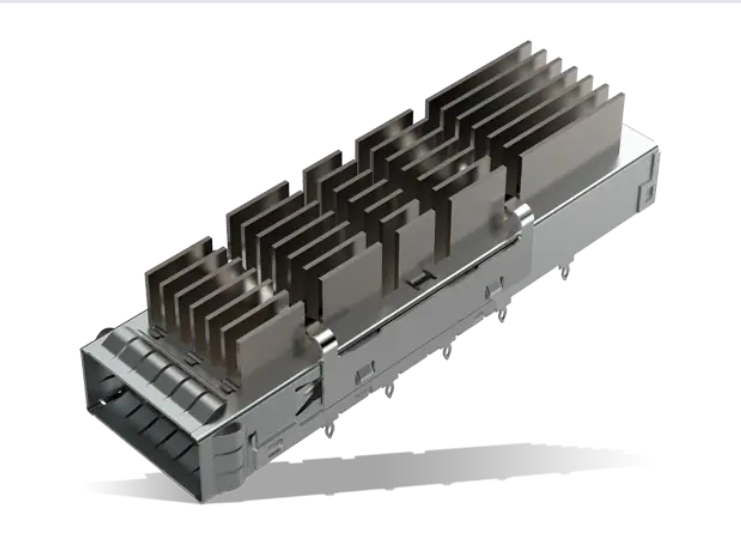
Amphenol Commercial QSFP雙倍密度 (DD) 互連系統
翻倍的傳輸頻寬與高度相容性
在技術規格上,Amphenol QSFP-DD 互連系統支援 25Gb/s NRZ 與 56Gb/s PAM4 訊號調變技術,單一連接埠可提供 200G 至 400G 的聚合頻寬。此外,該互連系統具備優異的向下相容性,可直接插入現有的 QSFP28 / QSFP+ 模組,為未來高頻寬升級提供彈性的硬體擴充能力。
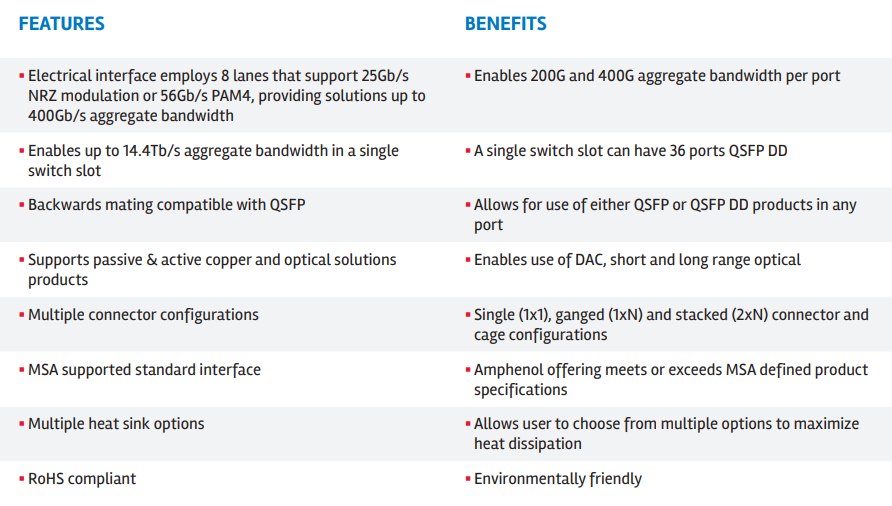
在規劃高階工作站與交換器時,QSFP-DD 的硬體結構主要分為三種:
1、Connector(連接器):焊接在主機板上的高速插槽,負責讓節點間的龐大 AI 數據順暢傳輸。
2、1xN Cages(單層籠架):罩在連接器外的金屬外殼,能有效隔離電磁干擾並加裝散熱片,適合一般工作站或 1U 伺服器。
3、Stacked 2xN(雙層堆疊):將插槽改為上下雙層設計,專為高密度交換器打造,能在有限面板空間塞入雙倍連接埠。
如果對Amphenol QSFP-DD 互連系統有興趣,可以聯絡Amphenol Commercial了解細部實驗數據、應用與產品採購
參考資料:
1、Set up a cluster of DGX Spark devices that are connected through Switch
2、Amphenol Commercial QSFP Double Density (DD) Interconnect System
輔助整理資料來源的AI:Google Gemini
留言 💬 (0)
還沒有留言,來當第一個。