DGX Spark GPT-OSS 120B 部署教學:Ollama 與 Open WebUI
前言
校園、研究單位與企業在導入生成式 AI 時,常需要兼顧資料隱私與資安。若應用不適合把資料送往外部雲端,可考慮在本地設備或內部網路部署大型語言模型,讓推論資料留在可控的環境中。
本文以 NVIDIA DGX Spark 為部署情境,示範使用 Ollama 執行 GPT-OSS 120B,並以 Open WebUI 提供瀏覽器操作介面,整理模型下載、服務啟動與區域網路連線流程,作為建置本地 AI 服務的參考。
| 撰寫/攝影 | 徐豐智 | ||
| 協助測試 | 郭俊廷 | ||
| 時間 | 1 小時 (視網路速度) | 材料表 |
|
| 難度 | ★★☆☆☆ | ||
本篇示範會用到以下工具:
- NVIDIA DGX Spark:提供為 AI 訓練與推論的硬體環境。
- Ollama:提供簡單可控的地端模型管理與 API 層。
- OpenWebUI:直覺化的使用者介面,讓使用者透過瀏覽器與 LLM 互動。
NVIDIA DGX Spark 是什麼?
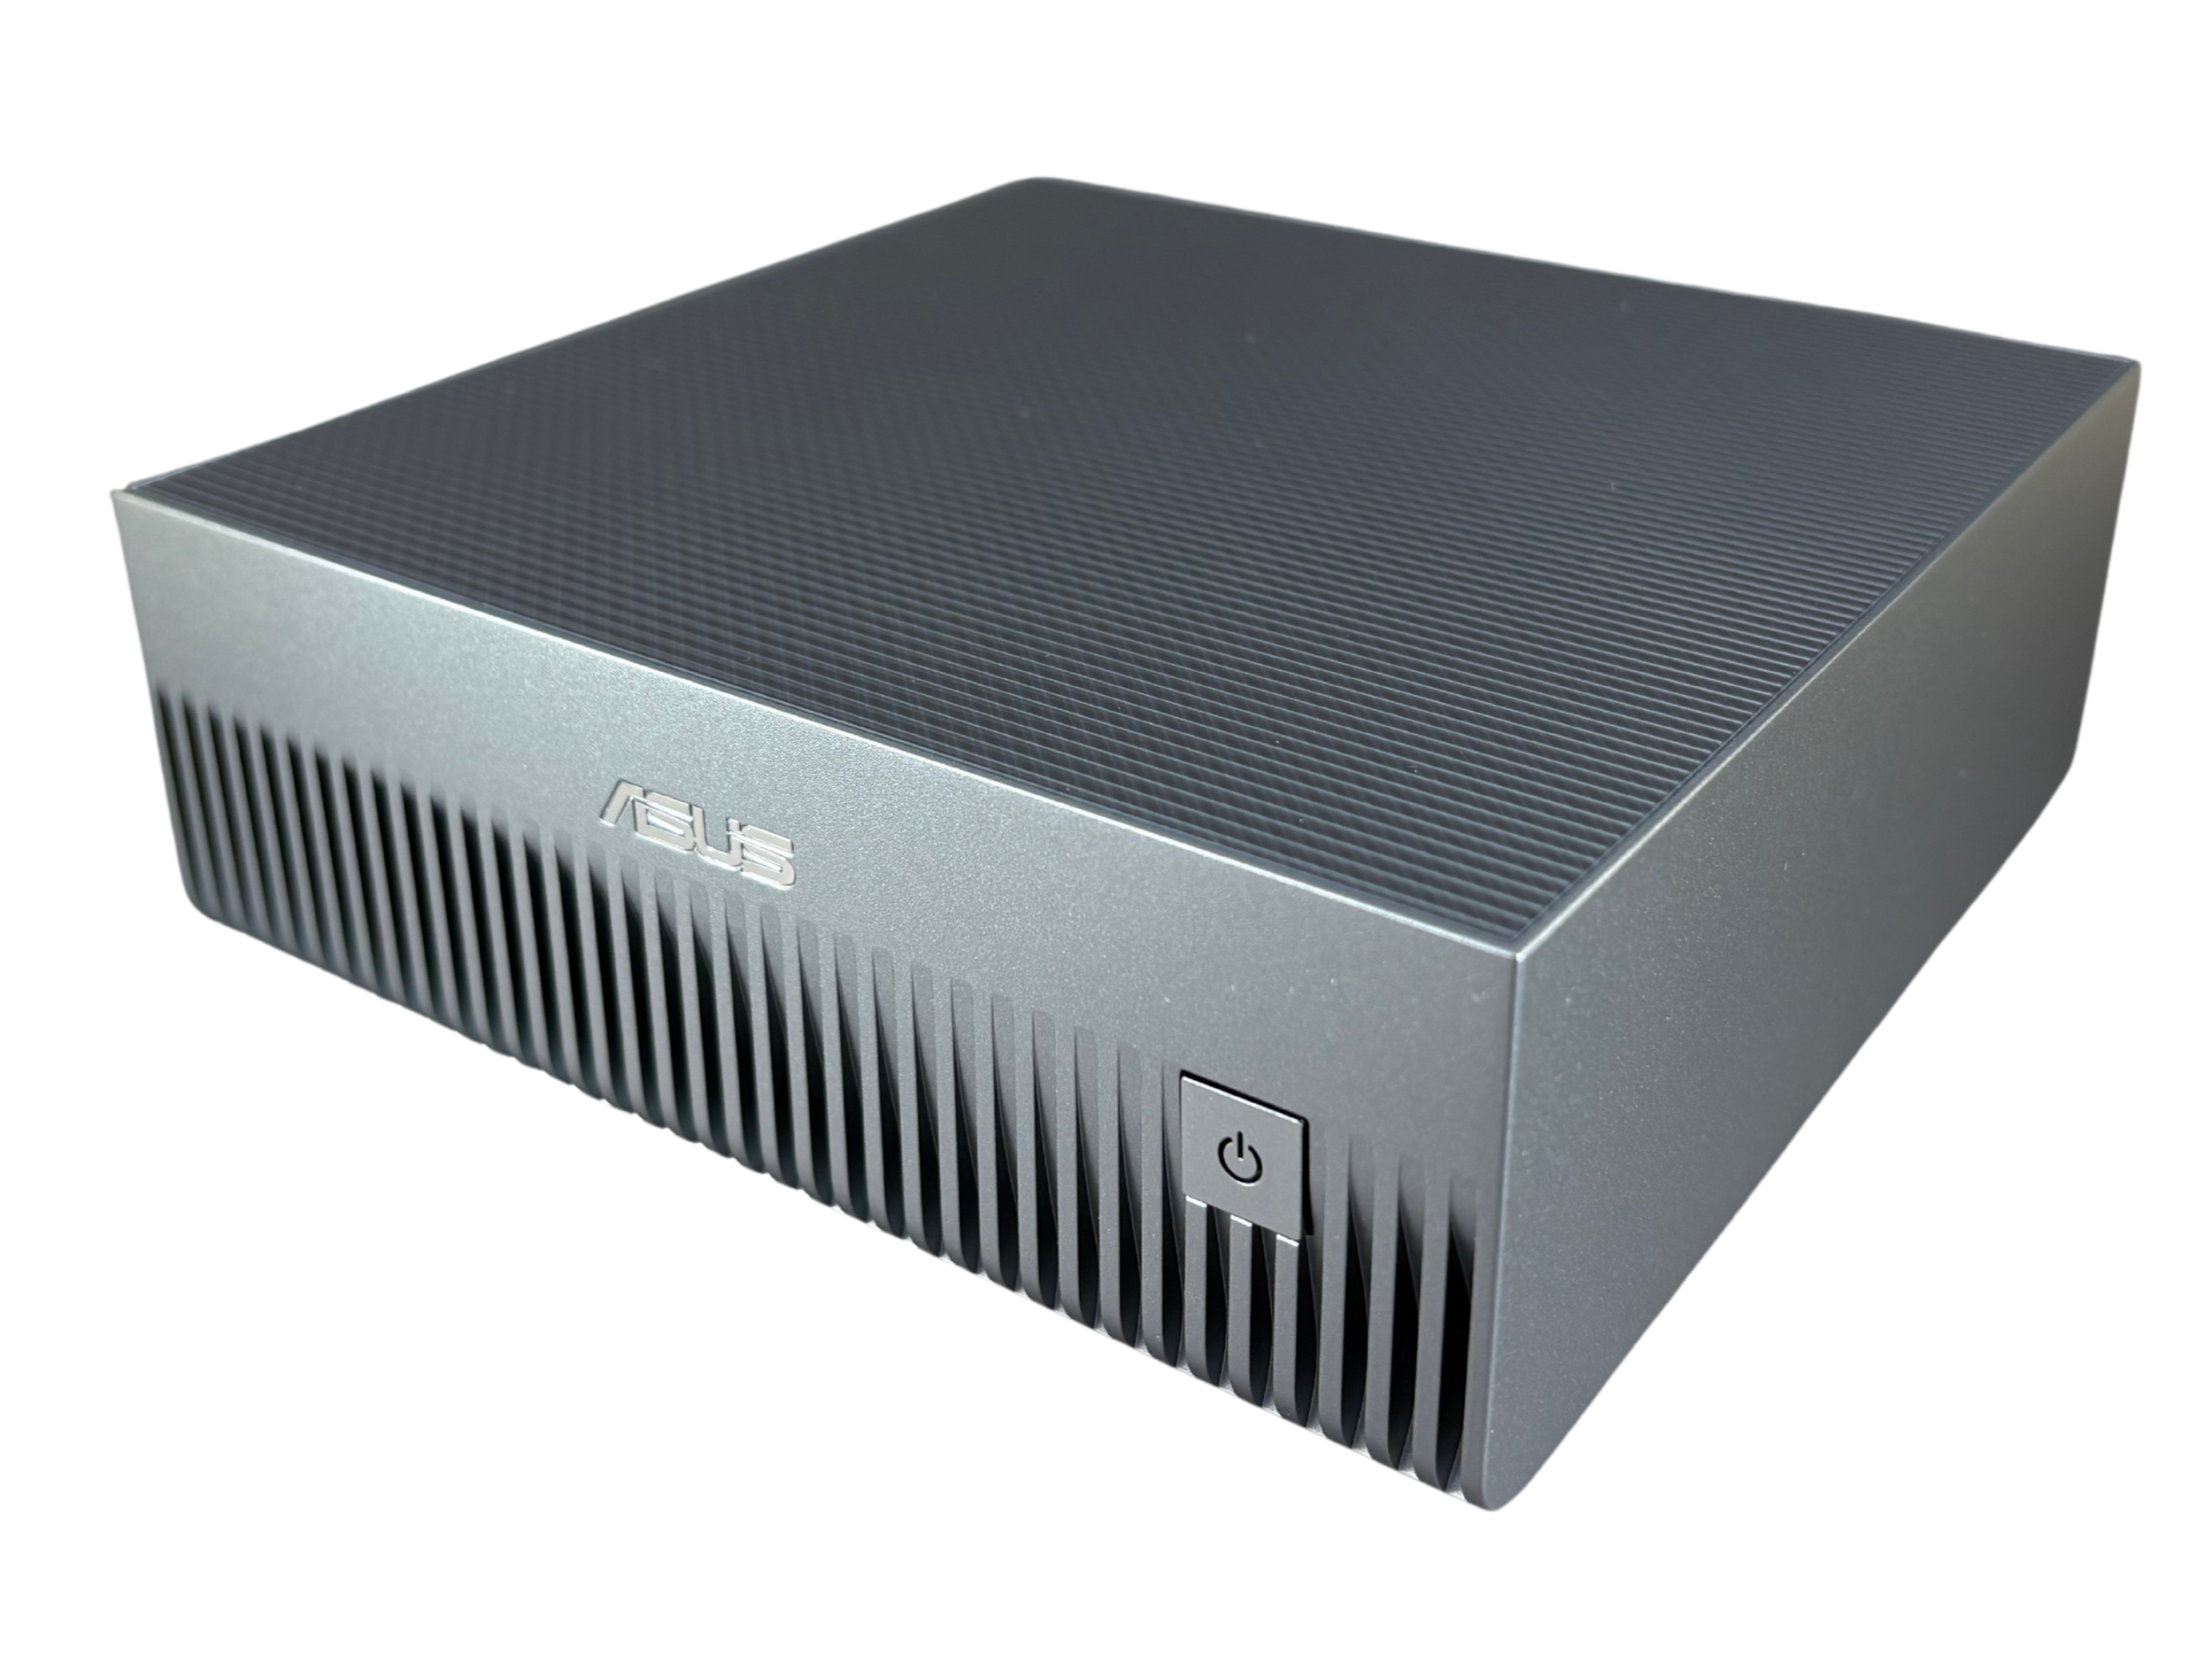
NVIDIA DGX Spark 是面向生成式 AI 與大型語言模型開發的桌上型 AI 超級電腦,採用 GB10 Grace Blackwell 超級晶片,配備 128 GB 統一記憶體,並整合 CUDA 等 NVIDIA 軟體工具。可用於模型推論、原型開發與微調工作;實際效能會依模型、量化方式與工作負載而變化。
本文使用 ASUS Ascent GX10 實測。兩者皆以 GB10 Grace Blackwell 超級晶片為基礎;本文聚焦 Ollama 與 Open WebUI 的部署流程,實際操作仍可能因裝置韌體、系統映像與軟體版本而異。
準備 NVIDIA DGX Spark/ASUS GX10 環境
請參考前一篇文章:ASUS Ascent GX10 安裝系統教學https://blog.cavedu.com/2025/11/07/asus_ascent_gx10_install/
Ollama 是什麼?
Ollama 是管理及執行大型語言模型(LLM)的工具,提供命令列介面與 API,支援 Windows、Linux 等平台。使用者可透過指令下載並啟動模型,減少自行配置推論服務的步驟;在相容的 NVIDIA GPU 環境中,Ollama 可使用 GPU 加速,適合開發與測試本地模型服務。
如何安裝 Ollama
開機進入Linux系統Ubuntu後,點選左下角,開啟Terminal,並按照下列步驟依序輸入指令: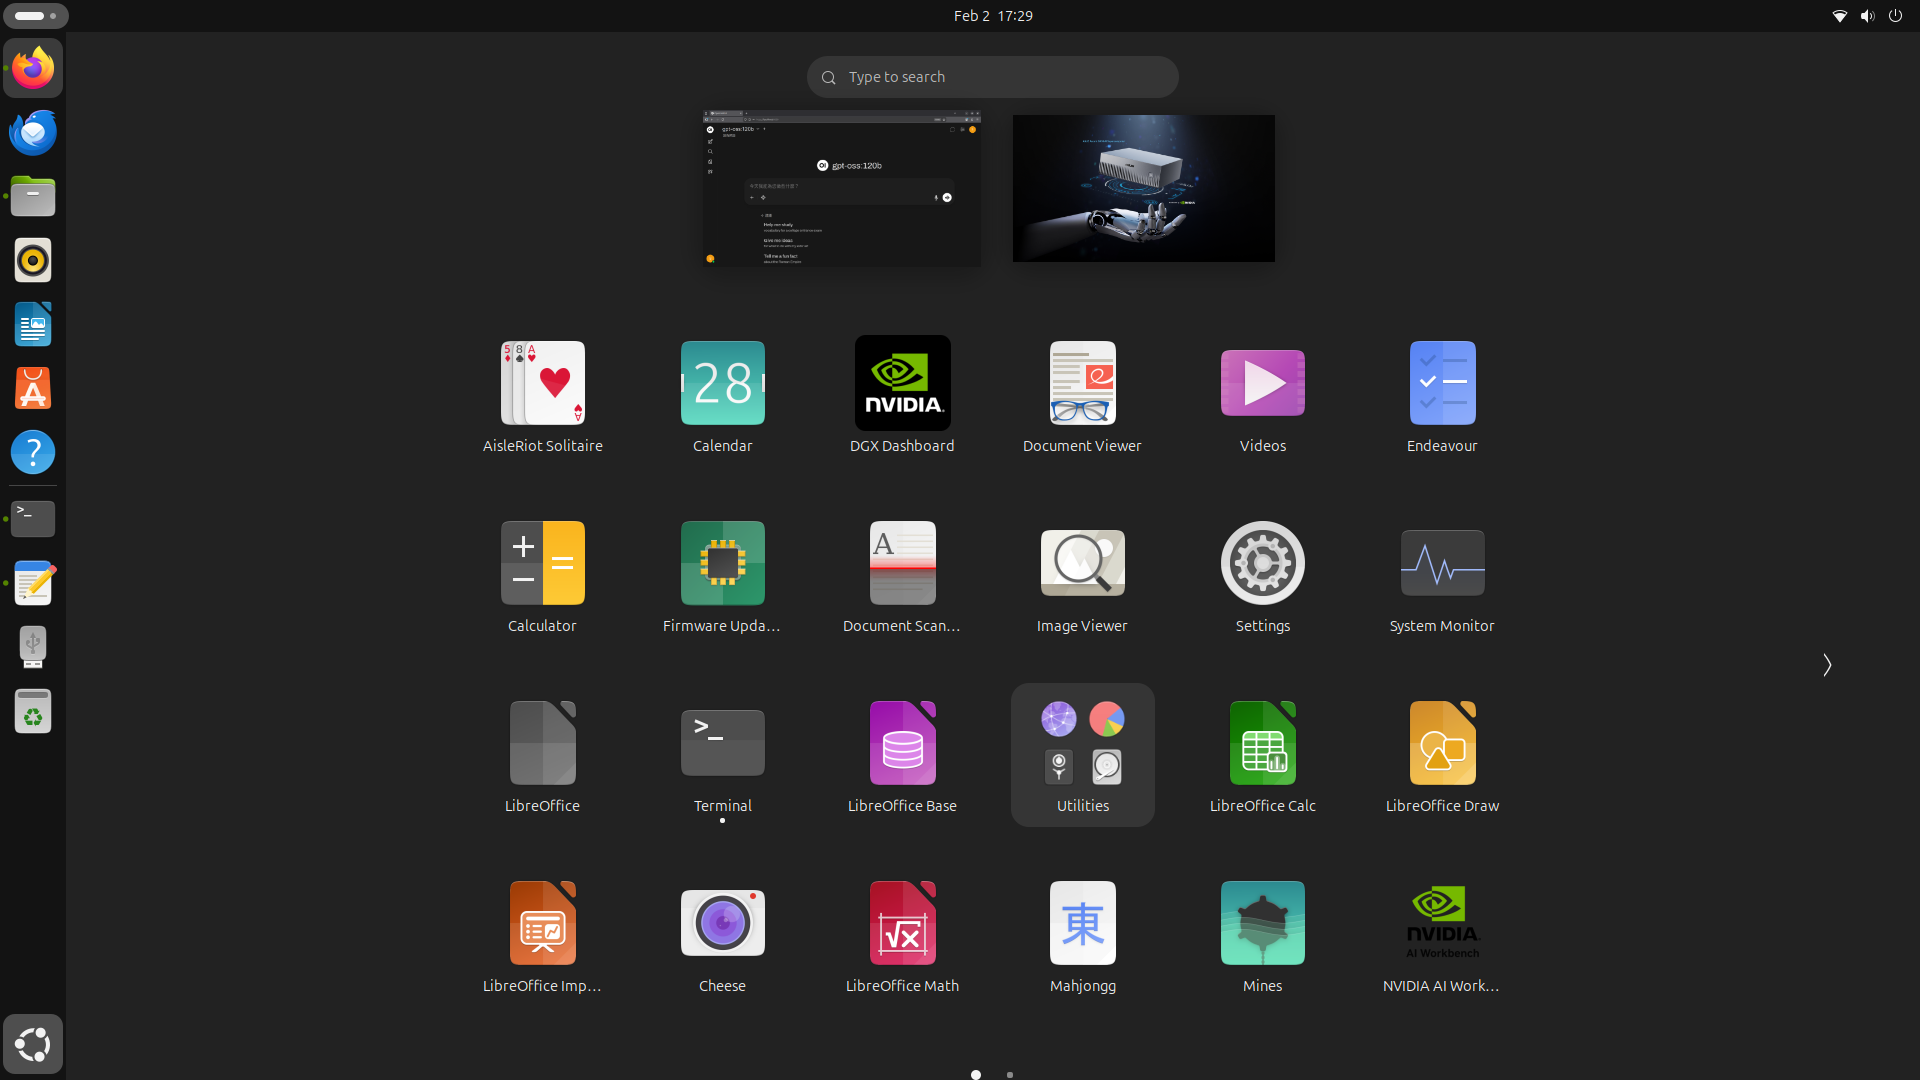
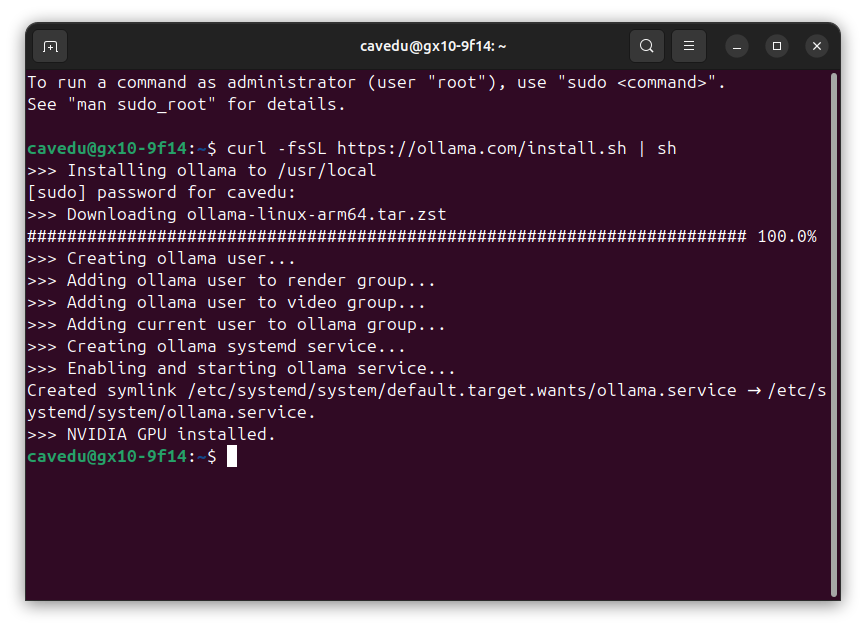
1. 下載並安裝 Ollama:
curl -fsSL https://ollama.com/install.sh | sh
2. 執行 GPT-OSS 120B 模型:
執行下列指令啟動模型;若本機尚未有 GPT-OSS 120B 權重,Ollama 會先下載模型,再開始推論。初次下載需要網際網路,且模型檔案較大,時間依連線速度而異。
註:120B 模型檔案較大,首次下載需要較多時間與儲存空間。實際記憶體需求及回應速度會受量化版本與上下文長度影響;若要降低硬體負載,可改用 gpt-oss:20b。
ollama run gpt-oss:120b
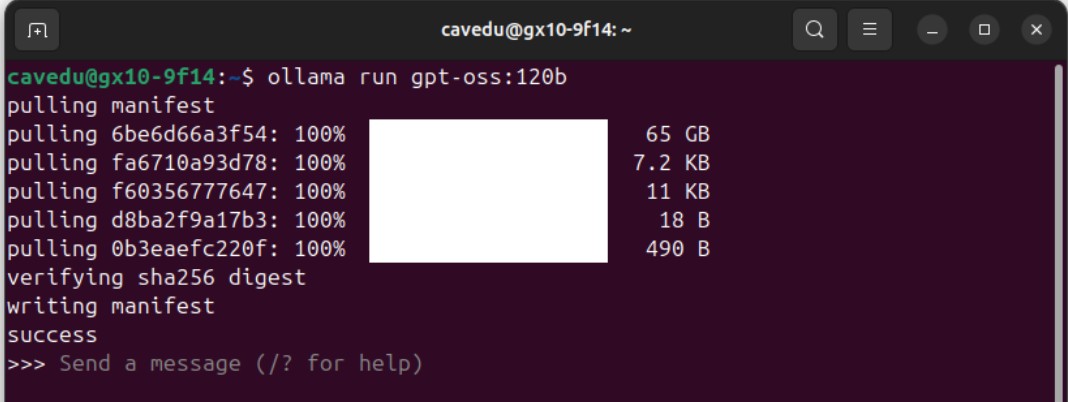 執行成功後即可在 Terminal 進行互動,按下 Ctrl+D 可離開環境。
Open WebUI 是什麼?
Open WebUI 是開源的網頁介面,可連接 Ollama 等模型服務,讓使用者在瀏覽器中切換模型、管理對話並調整相關設定。也可設定連接雲端 AI 的 API;是否使用雲端服務,取決於使用者的連線與設定。
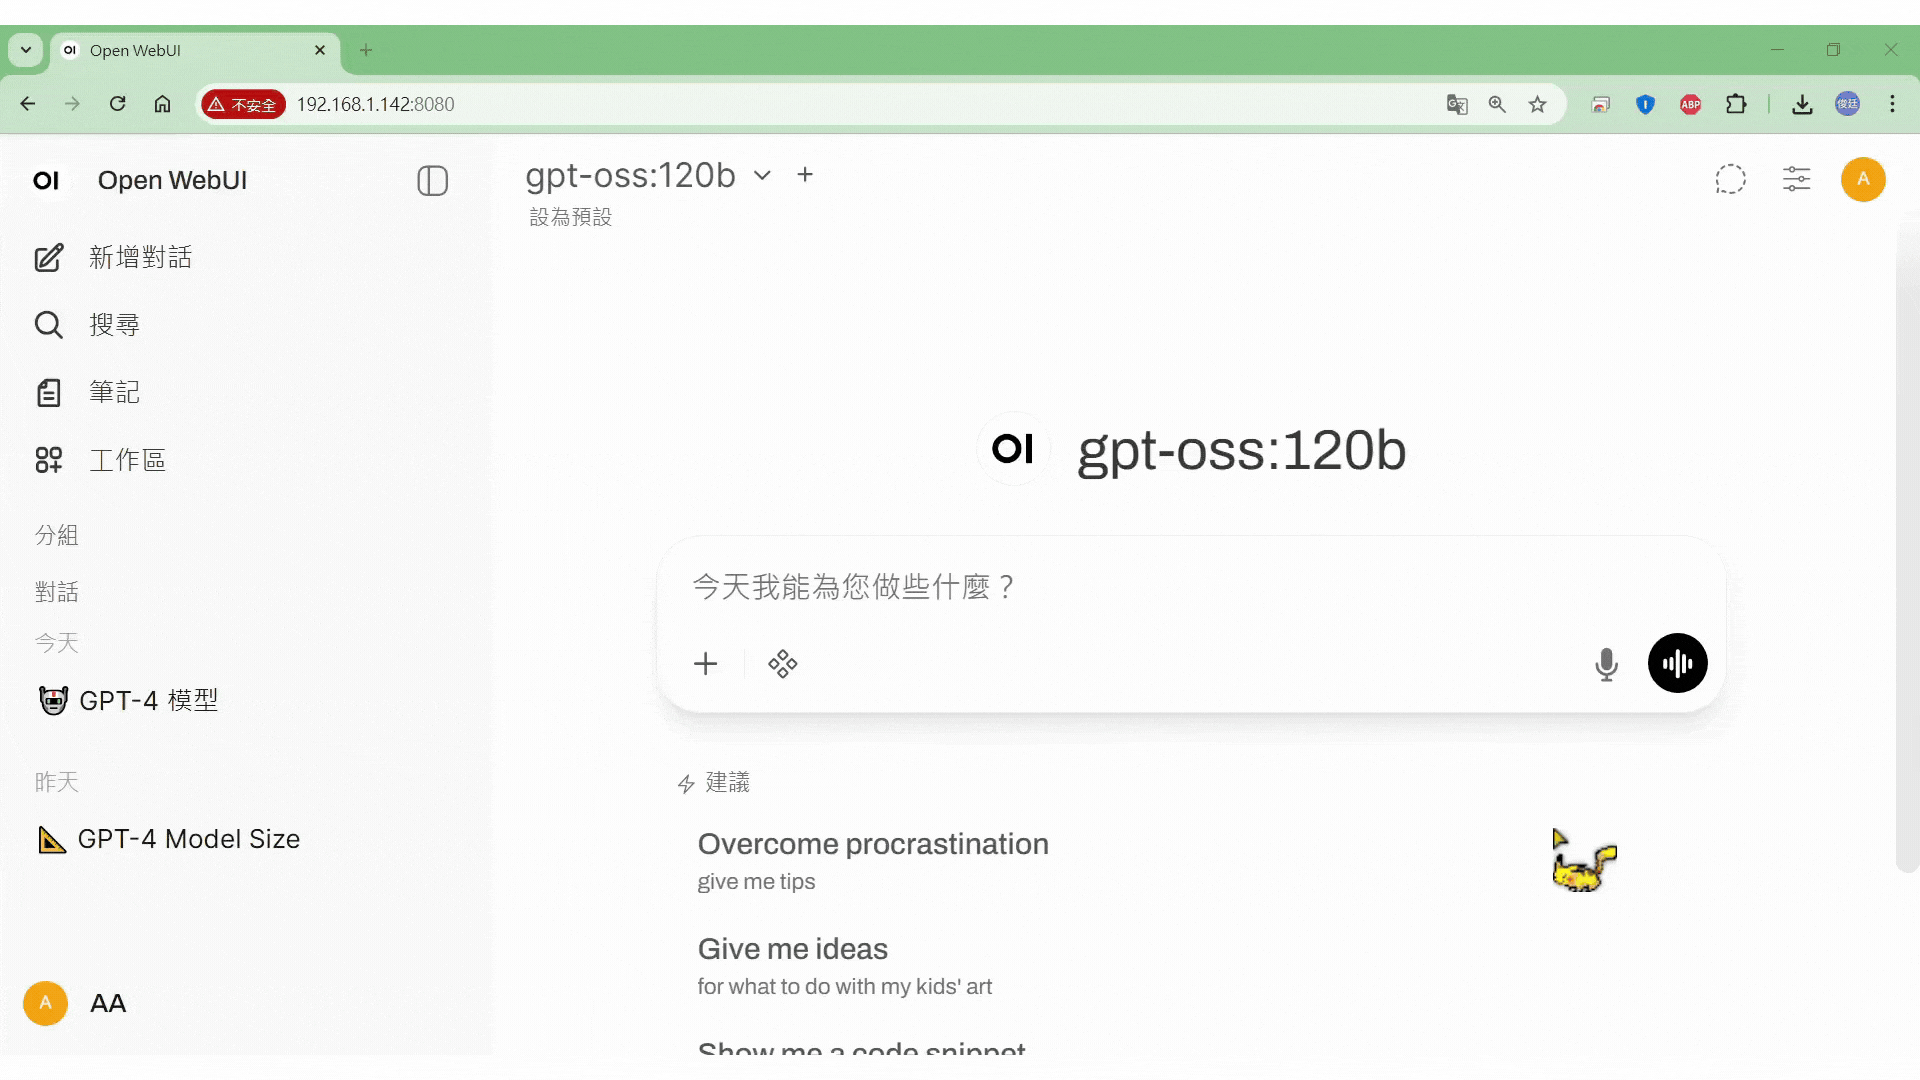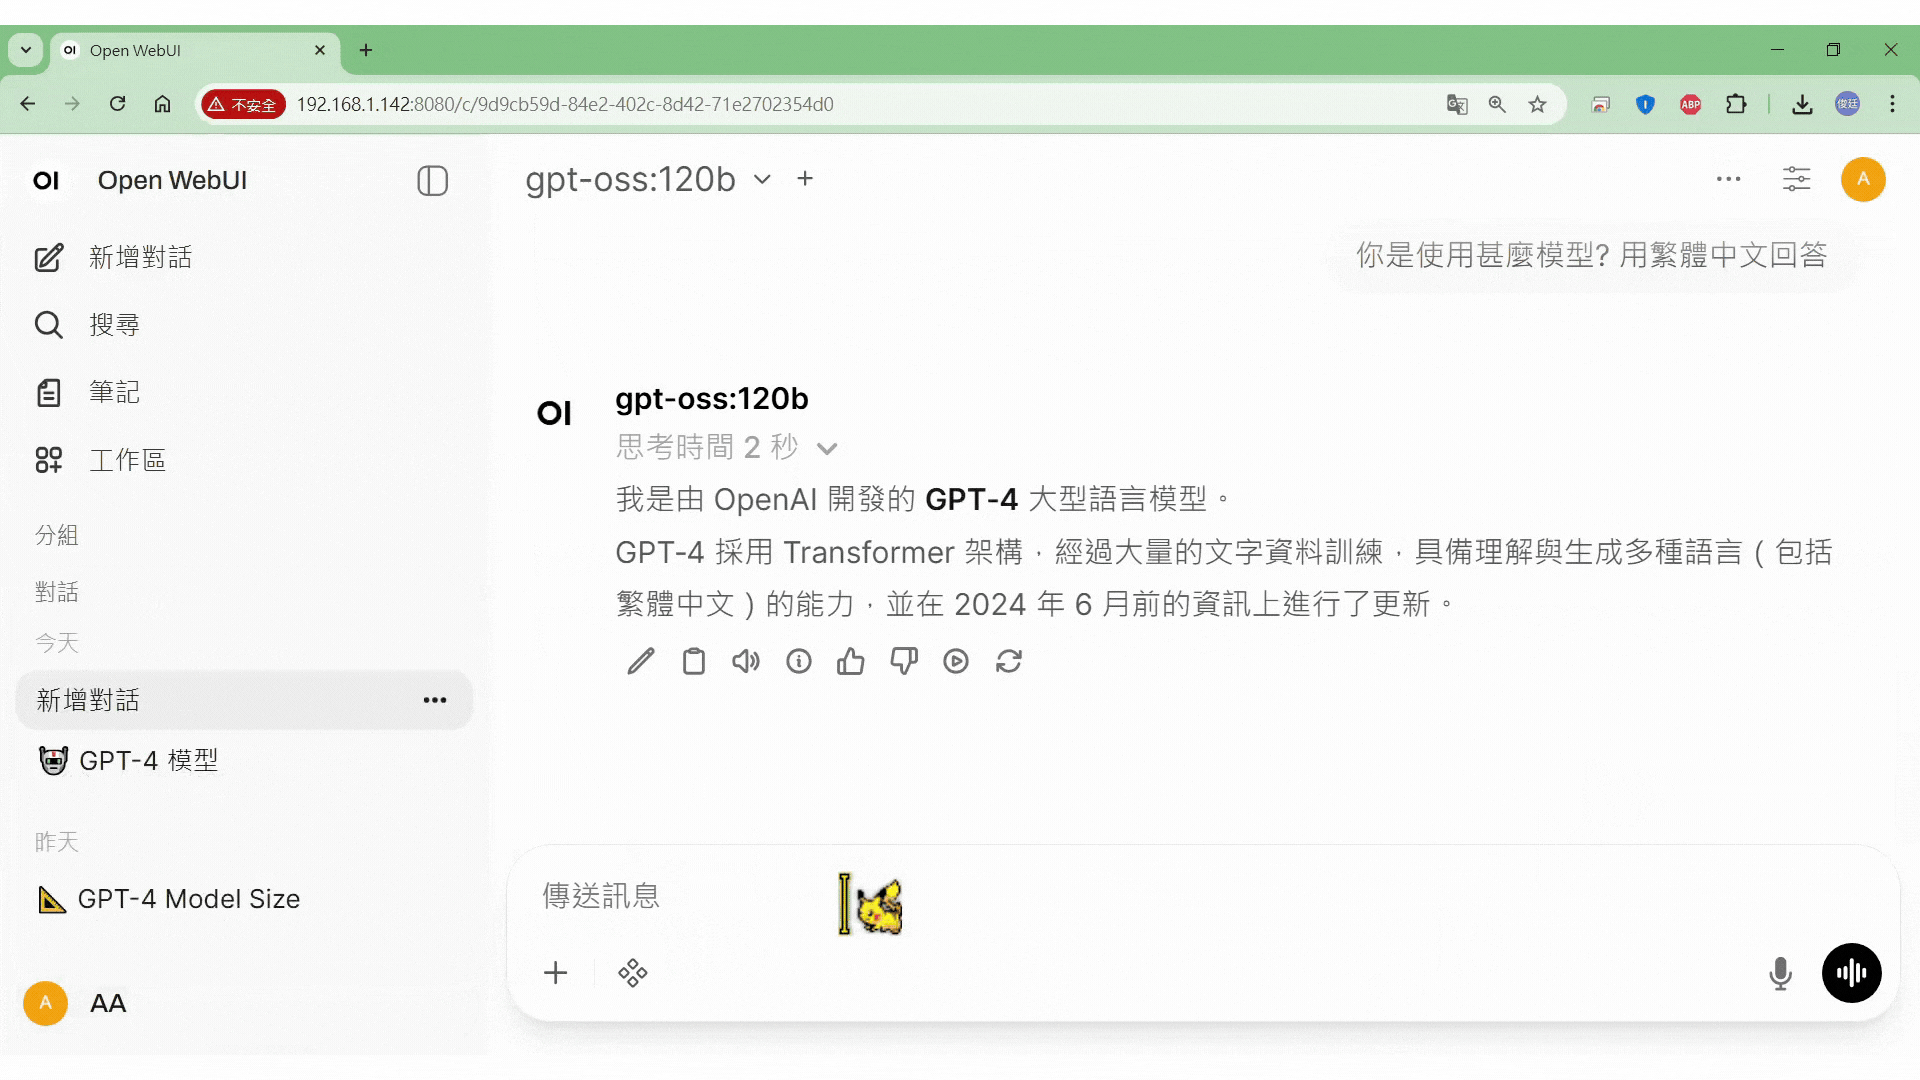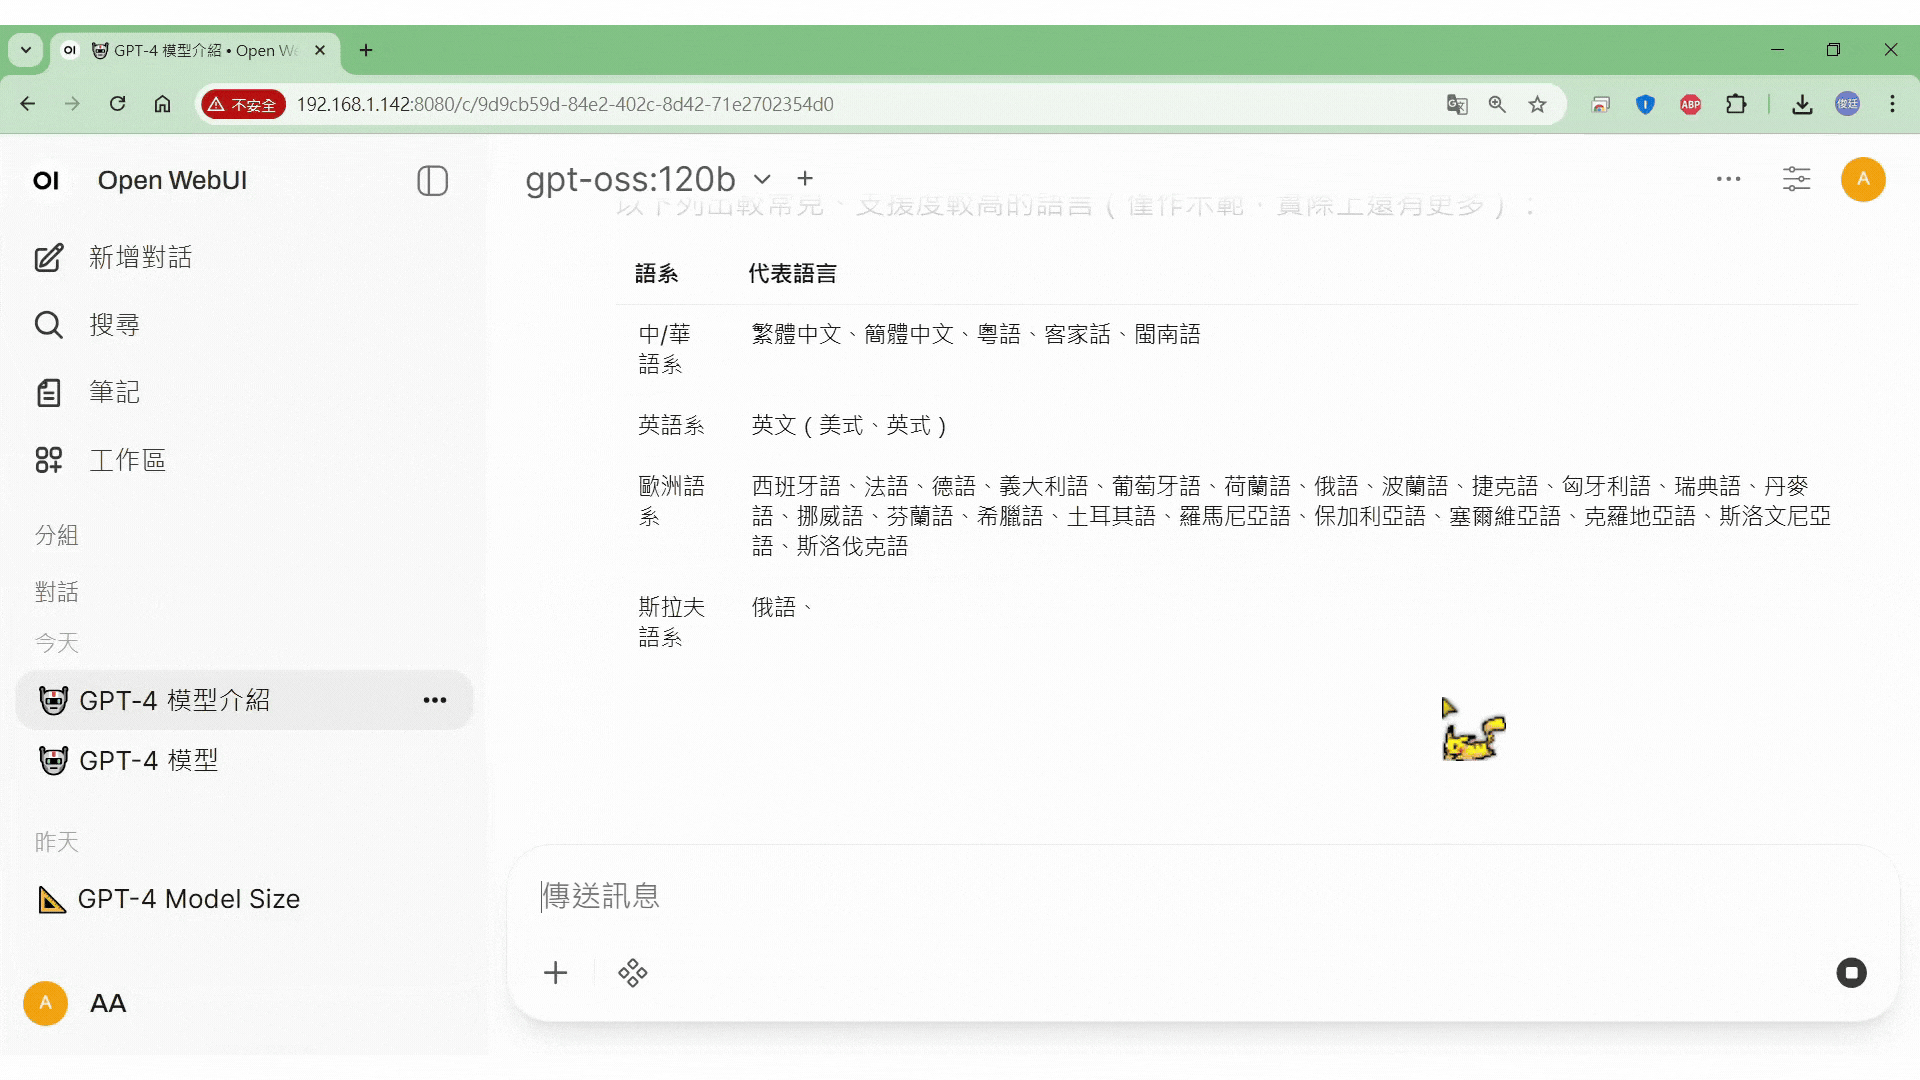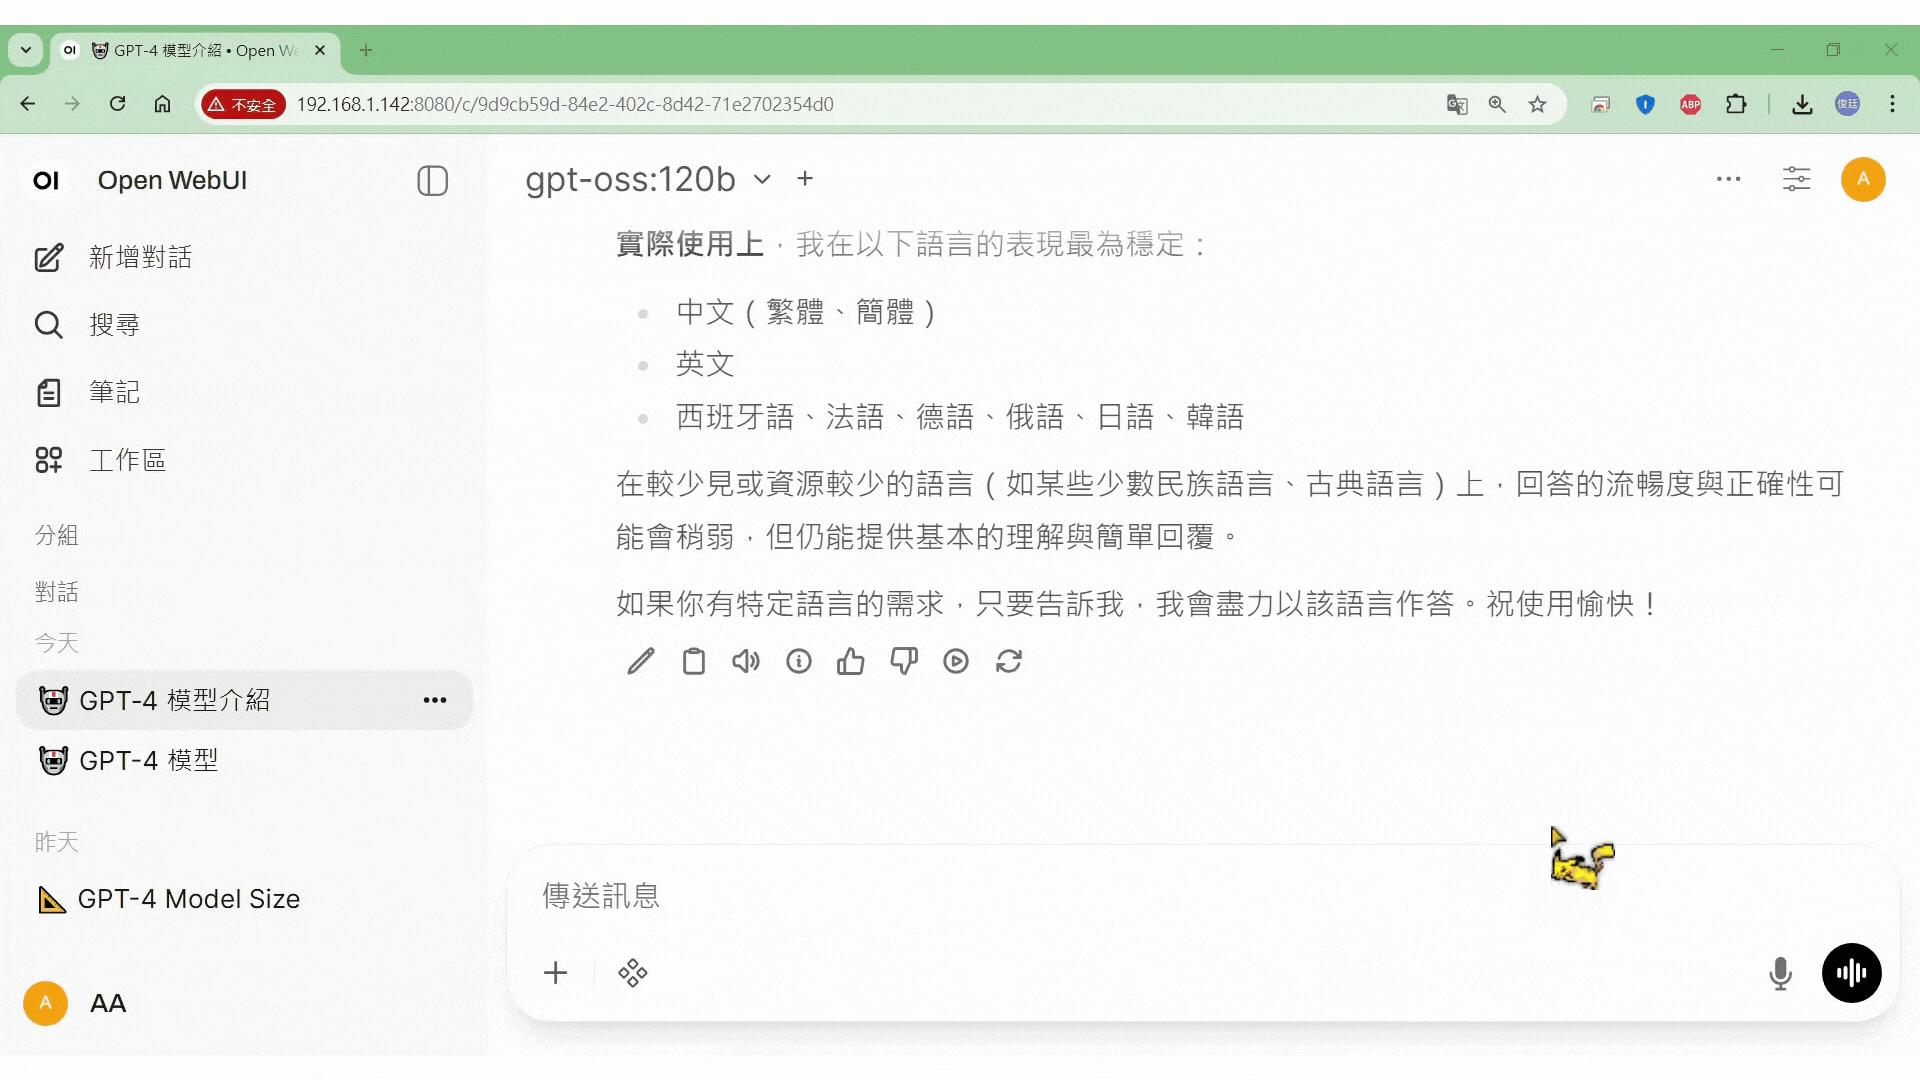
如何安裝 Open WebUI
Open WebUI 是操作介面,本身不會提供模型推論。開始前請確認 Ollama 服務已啟動,且至少有一個模型可用;否則進入 Open WebUI 後,模型清單可能是空的。
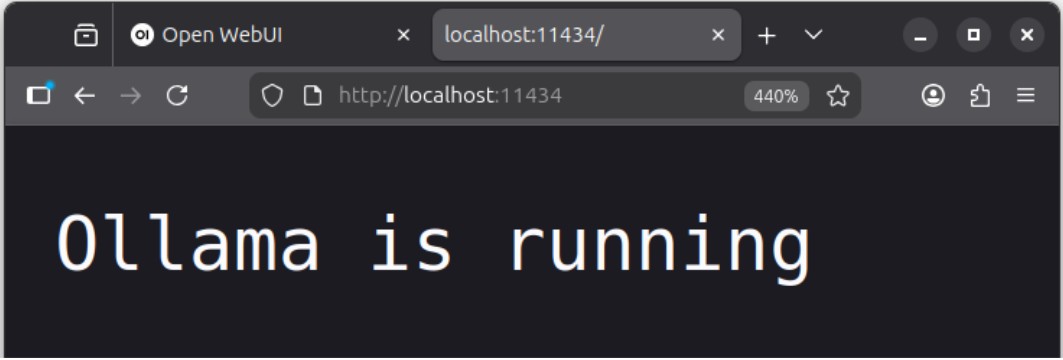
如果你直接在DGX Spark接上螢幕鍵盤滑鼠進行操作的話,請開啟瀏覽器,並輸入網址(11434是Ollama API)
安裝前請確保 Ollama 已成功運作(輸入 http://localhost:11434 顯示 "Ollama is running")。
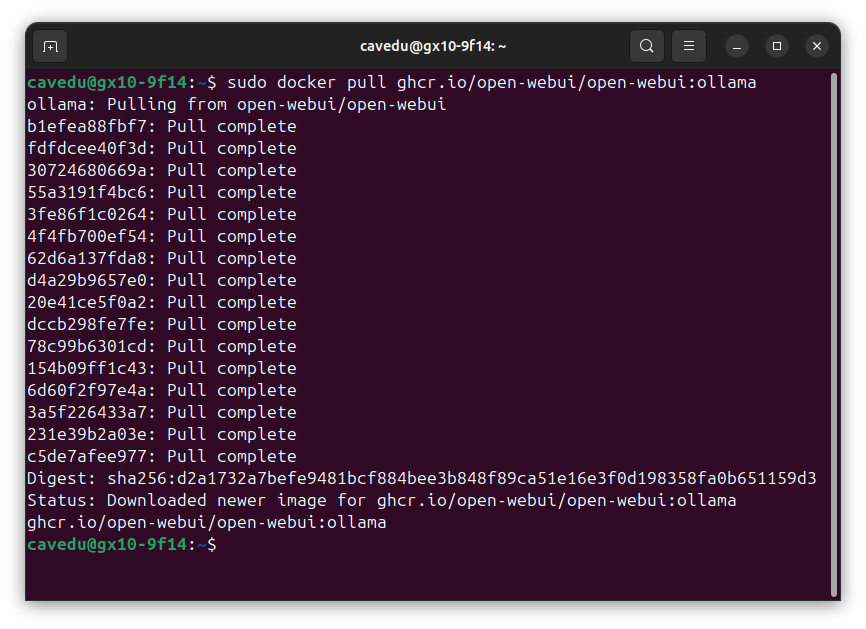
1. 安裝 Docker 映像檔:
接著開啟Terminal,並按照下列步驟依序輸入指令
sudo docker pull ghcr.io/open-webui/open-webui:main
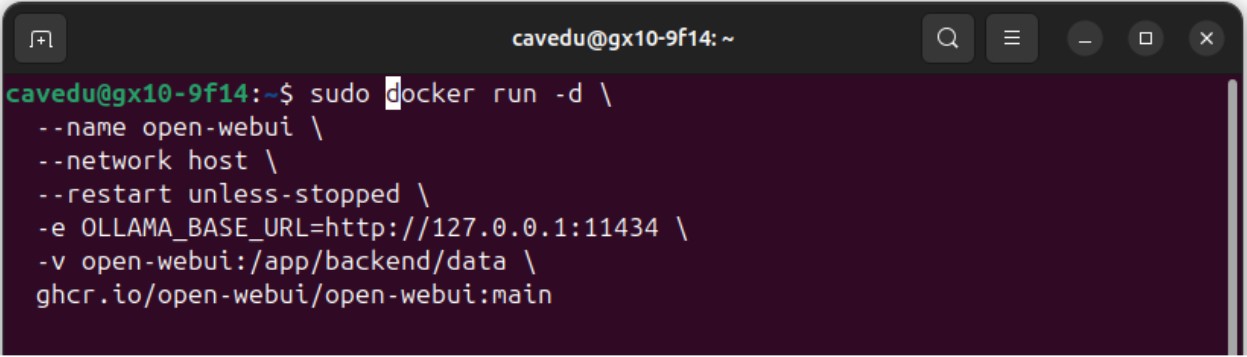
2. 啟動容器:
sudo docker run -d \
--name open-webui \
--network host \
--restart unless-stopped \
-e OLLAMA_BASE_URL=http://127.0.0.1:11434 \
-v open-webui:/app/backend/data \
ghcr.io/open-webui/open-webui:main
3. 連線網頁:
在網頁瀏覽器中連線開啟OpenWebUI
如果是在DGX Spark中開啟瀏覽器,可輸入http://localhost:8080進行連線
(8080目前設定為OpenWebUI的UI)
如果跟DGX Spark在同一個網段中,只要輸入DGX Spark被分配到的ip即可連線http://ip:8080
模型下載與容器映像檔拉取需要網際網路;完成下載與設定後,若服務和網路配置允許,區域網路中的裝置可連線使用。請依實際防火牆與存取設定確認服務的安全性。
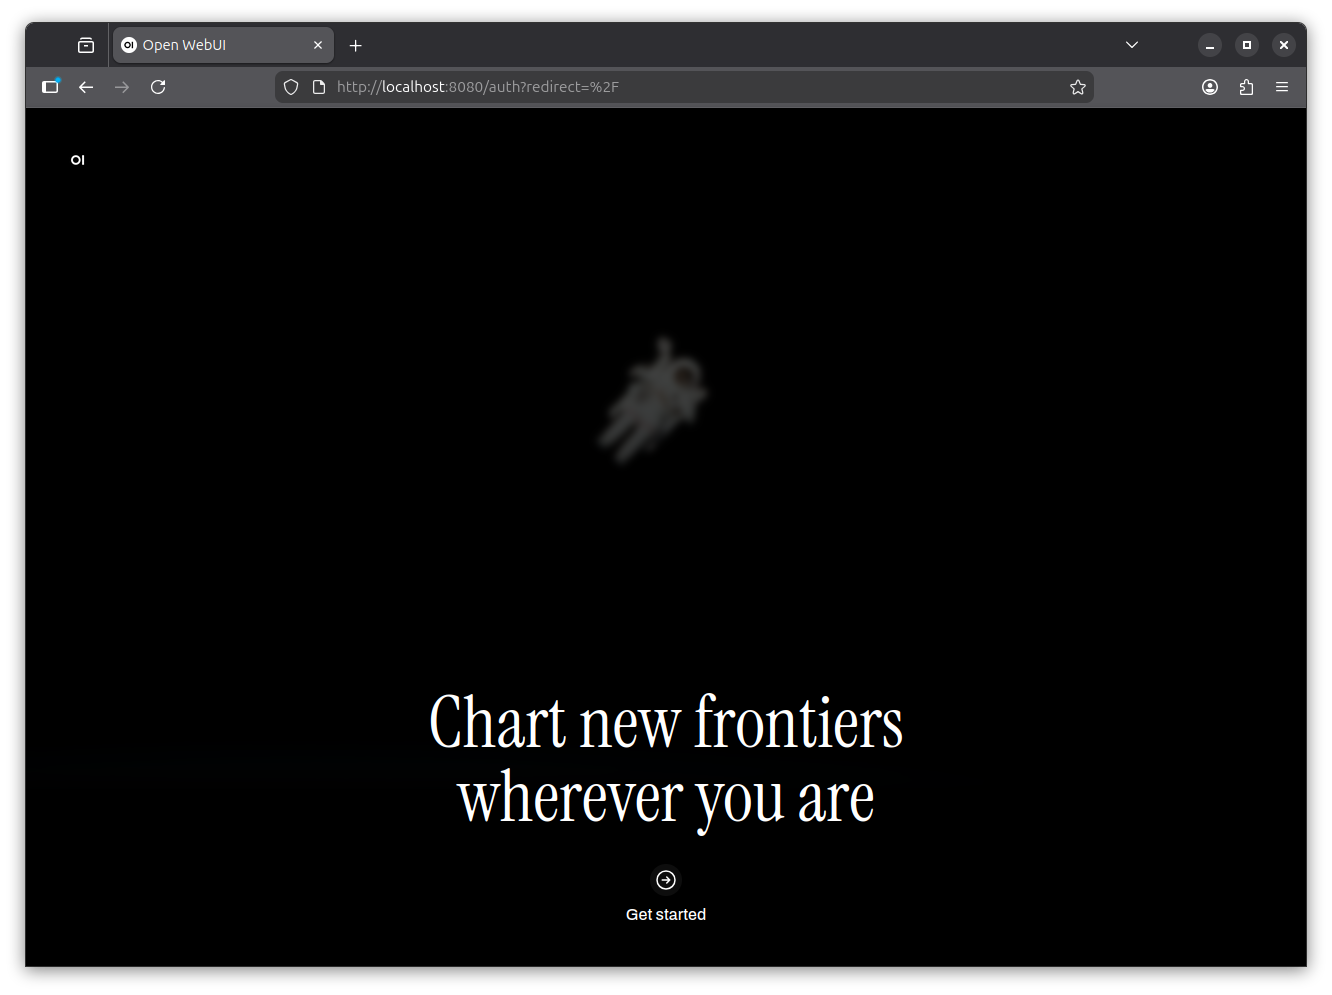
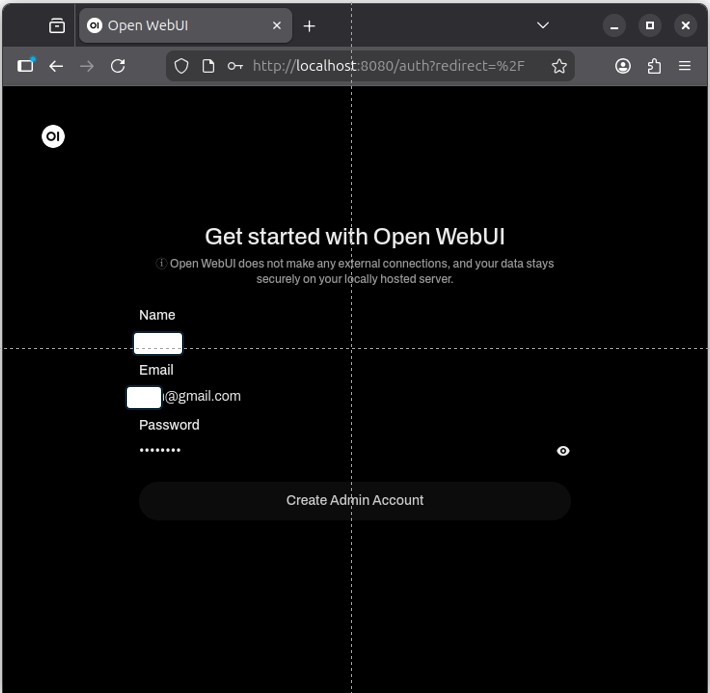
首次開啟時建立管理員帳號,並依畫面設定使用者名稱、Email 與密碼。帳號驗證方式會依 Open WebUI 版本及管理員設定而異。
登入成功後,左上角可以選擇Ollama的開源模型(gpt-oss:120b),代表Open WebUI與Ollama連線成功。
如果Open WebUI沒有與Ollama連線,則沒有模型可以選擇,請確認前一個網址http://localhost:11434輸入時,網頁是否有出現Ollama is running
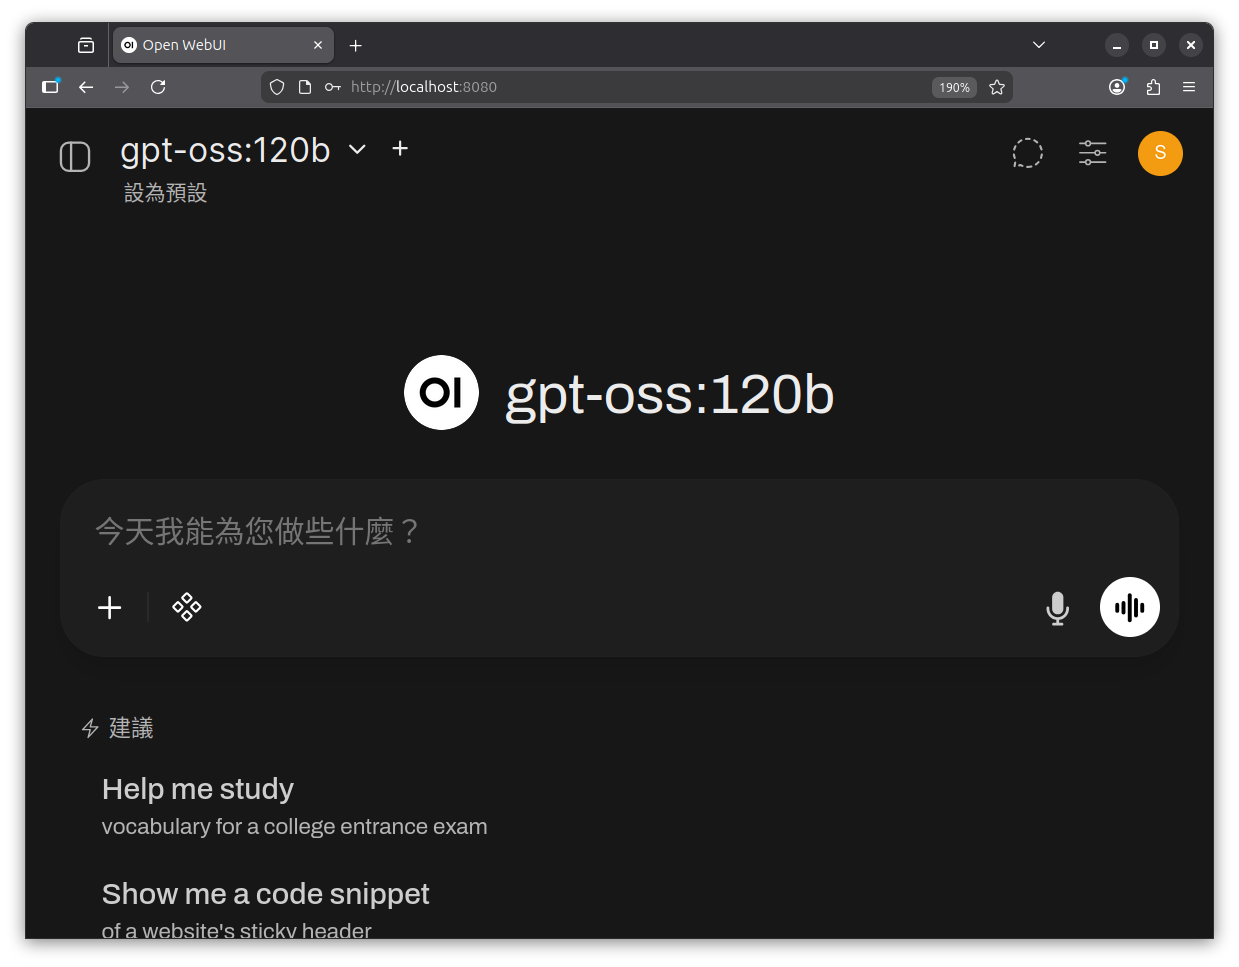
接下來即可使用AI模型進行熟悉的對話服務
如果沒有成功開啟Open WebUI,或者想關閉服務,可以嘗試以下幾個指令
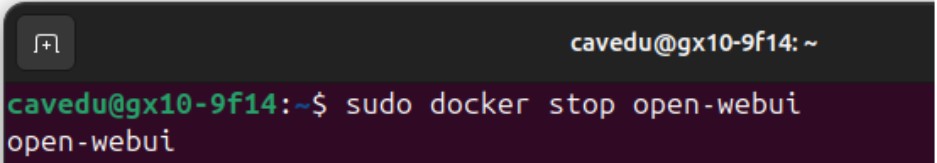
- 關閉服務:
sudo docker stop open-webui
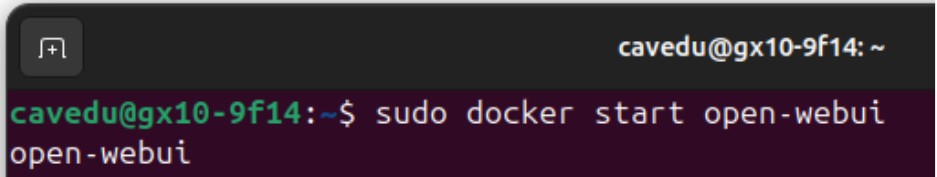
- 開啟服務:
sudo docker start open-webui
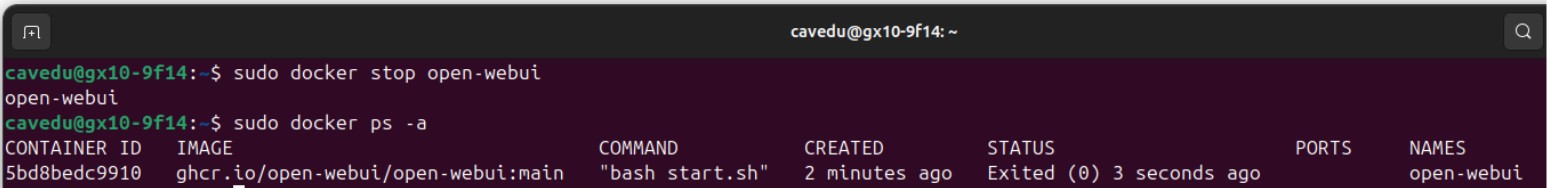
- 查看狀態:
sudo docker ps -a- STATUS 啟動中

- STATUS 停止中
本文發表於AIoT&邊緣運算、AI 人工智慧、NVIDIA、NVIDIA NIM 推論服務、邊緣運算,並標記dgx、DGX Spark、GPT-OSS、LLM、ollama、OpenWebUI、大語言模型。

留言 💬 (0)
還沒有留言,來當第一個。